Kuinka paljon RAM-muistia kannettava tarvitsee paikalliseen tekoälyyn?
Omalla kannettavallasi toimiva pieni tekoälymalli osaa jo lukea tekstiä, tulkita kuvia ja vastata kysymyksiisi ilman pilvitiliä. Lataa tänä iltana 3,4 Gt:n kokoinen malli qwen3.5:4b-q4_K_M (Qwen), niin se pystyy samaan tavallisella kannettavalla, jossa on 16 Gt keskusmuistia. Se on LLM eli suuri kielimalli. Lataa se Ollamalla, esitä yksi kysymys 4K-kontekstilla, ja käytössäsi on oikea tekoälymalli paikallisesti omalla koneellasi. Se ymmärtää tekstiä ja kuvia, ja kyse on inferenssistä, ei kouluttamisesta: mallille ei opeteta mitään uutta, vaan se vastaa kysymyksiin.
Kannettavan kyljessä oleva epämääräinen "AI PC" -tarra ei ole tekninen tieto. Käytännössä ratkaisevat RAM-muisti, GPU:n käytettävissä oleva muisti, tallennustila ja ohjelmistotuki. 16 Gt muistia on toimiva lähtötaso pienille tekoälymalleille. Se ei ole liian vähän, mutta ei myöskään lupaus siitä, että kaikki teknisissä tiedoissa mainittu onnistuu. Lisää muisti antaa enemmän kontekstia ja enemmän tilaa moniajoon. Alkuun 16 Gt riittää.
Mikä käyttää kannettavan RAM-muistia, kun ajat tekoälyä?
Mallin latauskoko ja sen RAM-muistin käyttö ajon aikana ovat kaksi eri asiaa, ja niiden sekoittaminen on yleisin virhe tekoälykäyttöön sopivaa kannettavaa valittaessa. qwen3.5:4b-q4_K_M:n 3,4 Gt on levyllä oleva tiedosto. Sen lataaminen käyttöön vie oikeaa muistia. Muistia vie myös konteksti-ikkuna eli käynnissä oleva keskustelu, jonka malli pitää mielessä vastatessaan, niin sanottu KV-välimuisti. Lisäksi muistia tarvitsevat itse ajomoottori sekä kaikki se, mitä käyttöjärjestelmä ja muut sovellukset jo käyttävät.
Ollama käyttää oletuksena 4 096 tokenin kontekstia, ja sitä voi kasvattaa. Jos ajat useita pyyntöjä samaan aikaan, kontekstimuistin tarve kasvaa suunnilleen rinnakkaisten pyyntöjen määrän mukana. Mallin teknisissä tiedoissa voidaan mainita 128K:n tai 256K:n konteksti-ikkuna, mutta sitä kannattaa pitää mallin ylärajana, ei lupauksena siitä, että 16 Gt:n kannettava pystyisi hyödyntämään kaiken siitä kerralla.
RAM, VRAM ja yhtenäinen muisti eivät ole sama asia
Apple Silicon -piireissä on yhtenäinen muisti: CPU ja GPU käyttävät samaa 16, 24 tai 32 Gt:n muistialuetta, joten erillistä näytönohjaimen muistia ei ole, joka voisi loppua kesken. Tyypillinen Windows- tai Linux-kannettava erillisellä NVIDIA-GPU:lla toimii toisin. Järjestelmän RAM-muisti ja GPU:n oma VRAM ovat kaksi erillistä muistialuetta, eikä 16 Gt järjestelmämuistia ja 8 Gt GPU-muistia tarkoita yhtä vapaasti käytettävää 24 Gt:n kokonaisuutta.
Jos malli ei mahdu kokonaan GPU:lle, osa siitä ajetaan CPU:lla. Tämä osittainen siirto voi tehdä teknisesti toimivasta mallista käytännössä selvästi hitaamman. Komento ollama ps näyttää tarkasti tämän CPU/GPU-jaon kaikelle, mikä on sillä hetkellä ladattuna.
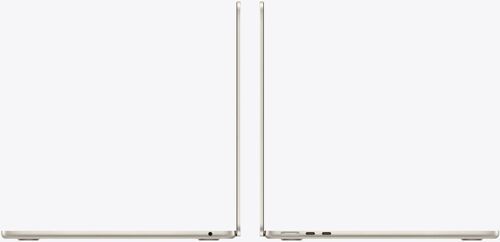
Kapasiteetti on vain puolet kokonaisuudesta. Yhtä tärkeää on se, kuinka nopeasti muisti siirtää dataa: Apple ilmoittaa MacBook Air M5:n muistikaistaksi 153 GB/s, ja juuri kaista, ei pelkkä koko, on olennainen syy siihen, miksi yhtenäinen muisti tuntuu ripeältä eikä vain niukasti riittävältä.
Kvantisointi: näin 9B:n tekoälymalli kutistuu mahtumaan muistiin
Kvantisointi selittää, miksi tuo lataus on vain 3,4 Gt: mallin painojen tallentaminen matalammalla numeerisella tarkkuudella pienentää tiedostoa, ja Qwen3.5:n oma 9B-malli havainnollistaa eron hyvin. Sama 9B-malli latautuu 6,6 Gt:n kokoisena Q4_K_M-versiona, 11 Gt:n kokoisena Q8_0-versiona ja 19 Gt:n kokoisena täydellä BF16-tarkkuudella. Sama malli, sama parametrimäärä, mutta kolme hyvin erikokoista latausta. Kyse on jälleen latauskoosta, ei RAM-muistista, jota malli tarvitsee käytössä.
Matalampi tarkkuus heikentää yleensä laatua jonkin verran, mutta vaikutus riippuu tehtävästä, ei kiinteästä prosentista. Yksi käytännön huomio ennen kuin valitset Qwenin ensimmäiseksi malliksesi: osa käyttäjistä kertoo sen "ajatteluvaiheen" tuovan selvän viiveen ennen vastauksen ilmestymistä verrattuna malleihin, jotka vastaavat suoraviivaisemmin. Kannattaa kokeilla molempia tyylejä omilla tehtävillä sen sijaan, että olettaisi toisen olevan yksinkertaisesti parempi.
Onko sinulla jo 16 Gt:n MacBook? Kokeile tätä ennen kuin ostat mitään
Jos käytössäsi on jo 16 Gt:n MacBook, aloita 2–4B-mallilla Q4-tarkkuudella ja 4K-kontekstilla ennen kuin harkitset mitään muuta ostosta. Myös 9B:n Q4-malli tai esimerkiksi Gemma 4 12B QAT saattaa latautua. Se, onnistuuko se, riippuu siitä, kuinka monta muuta sovellusta on auki, paljonko kontekstia käytät ja kuinka kuumana kone käy jo valmiiksi, joten tätä kannattaa pitää kokeilemisen arvoisena vaihtoehtona, ei varmana lupauksena.
Oletko ostamassa uutta juuri tätä käyttöä varten? MacBook Air 13-inch with M5 chip toimitetaan vakiona 16 Gt:n yhtenäisellä muistilla, ja sen voi konfiguroida jopa 32 Gt:iin asti. Ennen kuin isompi näyttö alkaa houkutella päivityksenä, muista tämä: 15-tuumainen M5 Air alkaa samoista 16, 24 ja 32 Gt:n muistivaihtoehdoista ja samasta 153 GB/s:n muistikaistasta kuin 13-tuumainen malli. Valitse näytön koko käyttömukavuuden perusteella, älä siksi, että odottaisit siitä lisää tekoälyvaraa. Sitä ei tule.
Onko sinulla jo 16 Gt:n Windows- tai Linux-kannettava? Aloita tästä
16 Gt:n Windows- tai Linux-kannettava ilman erillistä GPU:ta pystyy silti ajamaan pientä mallia. Ollama toimii natiivisti Windowsissa, joten lataa 2–4B:n Q4-malli ja kokeile sitä CPU:lla tai integroidulla grafiikalla ennen kuin käytät rahaa mihinkään. Käyttökokemus vaihtelee todennäköisesti enemmän kuin Apple Siliconilla: yhtä kiinteää tokens-per-second-lukua ei voi soveltaa kaikkiin koneisiin, koska kaikkia kokoonpanoja ei ole mitattu.
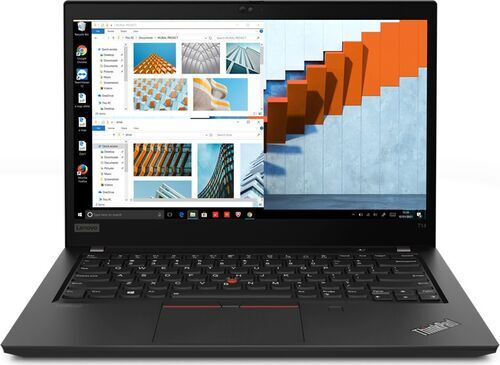
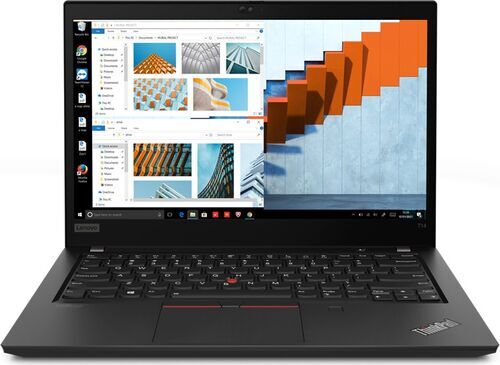
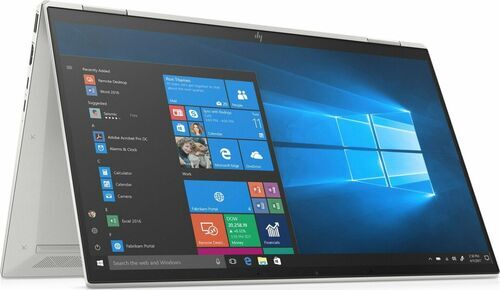
Lenovo ThinkPad T14 G2 ja HP EliteBook x360 1040 G7 ovat molemmat juuri tätä tasoa: 16 Gt RAM-muistia ja integroitu grafiikka. Yksi asia kannattaa tarkistaa ensin, etenkin vanhemmassa kunnostetussa koneessa kuten näissä: LM Studio vaatii Windows x64:ssä AVX2-tuen, eikä kaikissa vanhemmissa prosessoreissa sitä ole. Varmista siis, että juuri oma prosessorisi tukee sitä, ennen kuin oletat minkä tahansa tämän luokan kannettavan toimivan valitsemallasi työkalulla.
Kannettavien GPU-nimissä piilee ansa: miksi "RTX 5070 Ti" ei kerro kaikkea
NVIDIAn kannettavien GPU:t jakavat nimensä pöytäkoneiden näytönohjainten kanssa, mutta nimi kertoo vähemmän kuin voisi luulla. RTX 5060 Laptop GPU:ssa on 8 Gt GDDR7-muistia ja ilmoitettu tehoalue 45–100 wattia. RTX 5070 Ti Laptop GPU:ssa on 12 Gt GDDR7-muistia ja 60–115 wattia. Verkosta löytyvä pöytäkoneen RTX 5070 Ti -tulos ei kerro kannettavan RTX 5070 Ti:stä, vaikka nimi olisi sama.
Saman nimen sisällä on toinenkin ansa. Kahdessa kannettavassa voi olla "RTX 5070 Ti Laptop GPU", ja silti suorituskyky voi jatkuvassa kuormassa erota: ohut ja kevyt runko sekä paksumpi ja painavampi runko hallitsevat lämpöä eri tavoin, eikä sama GPU-nimi takaa samaa käytännön nopeutta sen jälkeen, kun tuulettimet ovat pyörineet jo hetken. Tarkista aina tarkka VRAM-määrä ja kannettavan oma tehoasetus, älä pelkkää GPU-perheen nimeä.
Uutta Macia ostamassa? Tämä on mukava yhtenäisen muistin taso
Jos ostat konetta nimenomaan paikallisen tekoälyn säännölliseen käyttöön, 24–32 Gt yhtenäistä muistia on Applen puolella selvästi mukavampi taso: se jättää tilaa suuremmalle mallille, pidemmälle kontekstille tai ihan vain sille, että muut sovellukset voivat pysyä auki työn aikana. Valitse 32 Gt, jos uskot käyttäväsi tätä usein ja budjetti antaa myöten.
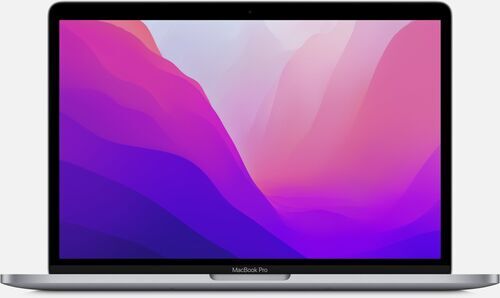
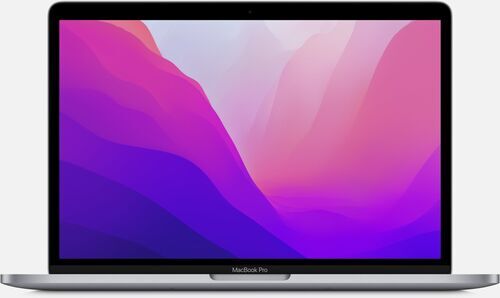
MacBook Pro 13-inch with M2 chip on hyvä kunnostettu esimerkki mallista, joka sijoittuu jo 16 Gt:n lähtötason yläpuolelle: sen 8-ytiminen CPU ja 10-ytiminen GPU yhdistyvät jopa 24 Gt:n yhtenäiseen muistiin. Piiri on vanhempaa sukupolvea kuin M5 Airissa, joten tässä mallissa realistinen yläraja on juuri 24 Gt, eivät M5 Airin erilliset 24/32 Gt:n konfiguraatiot.
Uutta Windows- tai Linux-kannettavaa ostamassa? Etsi erillinen GPU
Jos olet ostamassa uutta Windows- tai Linux-kannettavaa nimenomaan paikallista tekoälyä varten, etsi malli, jossa on 32 Gt järjestelmämuistia ja erillinen NVIDIAn kannettavan GPU, jossa on vähintään 8 Gt omaa VRAM-muistia, tai 12 Gt, jos hieman raskaampi tai kalliimpi kannettava sopii budjettiin. 8 Gt on uskottava tavoite 4–7B-malleille Q4-tarkkuudella ja kohtuullisella kontekstilla, mutta sitä ei kannata pitää automaattisena pelivarana: jo 9B:n Q4-mallin 6,6 Gt:n lataus voi vaatia enemmän kuin paljaan 8 Gt:n, jotta käyttö olisi mukavaa, ja 12 Gt tekee tämän kokoluokan testailusta yksinkertaisesti helpompaa.
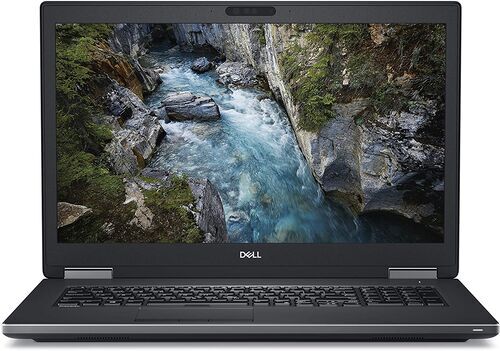
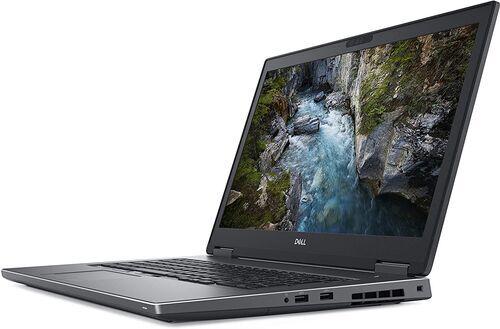
Dell Precision 7730 on hyvä kunnostettu esimerkki tämän ajatuksen taustalta, vaikka siinä ei olekaan juuri samoja uusia piirejä kuin edellä: 32 Gt järjestelmämuistia ja erillinen NVIDIA Quadro P3200, jossa on oma 6 Gt VRAM-muisti. GPU-sukupolvi ja -luokka ovat eri kuin NVIDIAn nykyisissä RTX 5060- ja 5070 Ti Laptop GPU -malleissa, mutta erillisten muistialueiden periaate on sama.
Varteenotettava vaihtoehto: AMD:n paljon muistia tukevat kannettavapiirit
AMD:n Ryzen AI Max+ 395 -prosessori tukee jopa 128 Gt LPDDR5x-järjestelmämuistia riippuen siitä, miten valmis kannettava on konfiguroitu. Tämä on erilainen muistiratkaisu, joka kannattaa tuntea, mutta mukana on myös selvä varaus: Ollaman Linuxin ROCm-tukilistalla tämä piiri on mukana, mutta Windowsin ROCm-listalla sitä ei toistaiseksi ole.
Se ei ole syy sivuuttaa koko piiriä, vaan syy varmistaa tarkka asennettu muistimäärä, käyttöjärjestelmä, GPU-backend, ajurit ja Ollaman käytös juuri siinä kannettavassa, jota harkitset, ennen kuin sitä voi suositella. Paljon muistia tarjoava AMD-kannettava kannattaa siis nähdä kiinnostavana vaihtoehtoisena arkkitehtuurina, johon on syytä perehtyä huolella, ei oletusostoksena ihmiselle, joka vasta aloittaa paikallisen tekoälyn käytön.
Ohjelmistokerros: Ollama ja LM Studio selkokielellä
Ollama on yksinkertaisin tapa saada malli keskustelemaan omalla koneellasi: lataa malli, käynnistä se, ja käytössäsi on paikallinen palvelin, joka vastaa pyyntöihin ilman pilvitiliä, kun kyse on ladatusta mallista. Se on kaikkien tässä esiteltyjen esimerkkien taustalla.
LM Studio tarjoaa graafisen vaihtoehdon omalla malliselaimellaan ja chat-ikkunallaan. Se julkaisee myös omat vähimmäisvaatimuksensa: vähintään 16 Gt RAM-muistia Macilla tai Windowsilla, AVX2-tuki pakollinen Windows x64:ssä, ja Windowsissa suositellaan 4 Gt erillistä VRAM-muistia. Kummankin työkalun kunnollinen käyttöönotto on jo oma aiheensa.
Yksi varoitus ennen kuin luotat yhteen verkossa näkemääsi nopeuslukuun: virallinen llama-bench-työkalu erottaa promptien käsittelynopeuden ja generointinopeuden toisistaan sekä raportoi vaihtelun toistettujen testien välillä yhden ainoan luvun sijaan. Foorumiviesti, jossa mainitaan yksi tokens-per-second-luku, kertoo harvoin, kumpaa näistä on mitattu tai kuinka monta kertaa testi ajettiin.
Tarkistuslista tekoälyvalmiin kannettavan ostoon tai päivittämiseen
Ennen kuin ostat tai päivität kannettavan nimenomaan paikallista tekoälyä varten, tarkista yksityiskohdat, älä markkinointia.
Tarkka GPU-malli ja VRAM-määrä. Ei pelkkä GPU-perheen nimi, vaan juuri sen kannettavan tarkka versio ja sen oma muistimäärä, koska saman nimen takana voi olla eri määrä VRAMia.
Onko RAM juotettu kiinni vai päivitettävissä. Joihinkin kannettaviin voi lisätä muistia myöhemmin, moniin moderneihin ohutrakenteisiin malleihin ei. Tiedä, kumpaa olet ostamassa.
Vapaa SSD-tallennustila. Mallien lataukset vaihtelevat alle gigatavusta reilusti yli kymmeneen, ja kasvava kokoelma vie nopeasti tilaa muiden tiedostojen rinnalla.
Lämpökäytös jatkuvassa kuormassa. Yhteen kysymykseen vastaava malli ja useita pyyntöjä peräkkäin käsittelevä kannettava ovat eri testi. Tuulettimien melu ja suorituskyvyn rajoittuminen toistuvien promptien jälkeen kertovat enemmän kuin yksi nopea demo.
Käyttöjärjestelmä- ja ajurituki. Varmista, että juuri oma GPU-backendisi ja käyttöjärjestelmäyhdistelmäsi on tuettu Ollamassa tai LM Studiossa ennen kuin oletat mitään.
Laatikon NPU TOPS -luku ei takaa läpimenoa. Se on markkinointiluku, ei testattu tulos siitä moottorista, jota aiot käyttää. Epämääräinen "AI PC" -merkintä ei korvaa yhtäkään yllä olevista tarkistuksista.
Viisi kunnostettua kannettavaa, jotka sopivat näille tasoille jo nyt
Usein kysyttyä tekoälyn ajamisesta kannettavalla
Tarvitsenko erillisen GPU:n paikalliseen tekoälyyn?
Et. Pieni malli toimii CPU:lla tai integroidulla grafiikalla monissa 16 Gt:n kannettavissa, mutta nopeus vaihtelee enemmän kuin kannettavassa, jossa on erillinen GPU. Aloita 2–4B-mallilla ennen kuin oletat tarvitsevasi erillistä grafiikkaa lainkaan.
Riittääkö 8 Gt RAM-muistia?
Ei mukavasti niille malleille, joita tässä käsitellään. 16 Gt on realistinen lähtötaso, kun huomioi, että malli, sen konteksti-ikkuna, ajomoottori ja käyttöjärjestelmä käyttävät samaa muistia.
Onko mallin paikallinen ajaminen sama asia kuin sen kouluttaminen?
Ei. Kaikki yllä oleva on inferenssiä: kysymysten esittämistä jo koulutetulle mallille. Kouluttaminen rakentaa mallin alusta alkaen ja vaatii paljon enemmän laitteistoa kuin mikään tässä mainituista kannettavista.
Takaako suurempi RAM-muisti nopeammat vastaukset?
Ei. Lisää muisti tuo enemmän pelivaraa suuremmille malleille, pidemmälle kontekstille ja useammalle auki olevalle sovellukselle, mutta todellinen nopeus riippuu muistikaistasta, GPU-backendista ja itse mallista, ei pelkästä muistin määrästä.
Pysyykö data yksityisenä, kun malli toimii paikallisesti?
Kyllä siinä mielessä, että promptisi pysyvät omalla koneellasi eivätkä siirry pilvipalveluntarjoajalle. Ollama sitoutuu oletuksena omaan kannettavaasi eikä lähetä pyyntöjä minnekään muualle, ellei pilviyhteyttä määritetä tarkoituksella.
Kokeile tänään, osta sitten varmemmin
Onko sinulla jo 16 Gt:n kannettava? Asenna Ollama tänä iltana ja aja yksi pieni malli ennen kuin käytät euroakaan mihinkään uuteen. Ostatko konetta nimenomaan tähän käyttöön? Käytä yllä olevaa tarkistuslistaa ja juuri läpikäytyä viittä kunnostettua kannettavaa vertailun lähtökohtana, älä markkinoinnin teknisiä lupauksia.
Jokainen refurbed-kannettava testataan ja luokitellaan ennen myyntiin lisäämistä, joten ostamasi RAM-muisti ja kokoonpano ovat juuri ne, jotka myös saat. Tämän sarjan seuraava opas käy läpi, miten yhdistät ensimmäisen sovelluksesi malliin, jota juuri kokeilit.


Liity ensimmäistä kertaa uutiskirjeen tilaajaksi ja säästä 15 €!
Älä missaa enää yhtäkään tarjousta.
Lisätietoja henkilötietojen käytöstä löydät tietosuojaselosteestamme.
Hanki refurbed-sovellus
iOS:lle ja Androidille


Vahvista rekisteröityminen
Napsauta linkkiä lähettämässämme vahvistussähköpostissa saadaksesi etukuponkisi. Sen voi käyttää vähintään 200 euron ostokseen.
- © Refurbed Marketplace GmbH
- Saavutettavuudet
- Ehdot
- Tietosuojaseloste
- Julkaisutiedot
- Oikeudelliset ilmoitukset
- European Data Act
- Cookie Policy