Parhaat pienet tekoälymallit omalle kannettavalle: kompakti työkalupakki
qwen3.5:4b-q4_K_M vastaa kysymyksiin täysin ilman verkkoyhteyttä tavallisella 16 Gt:n kannettavalla. Sarjan toisesta osasta tuttu malli on hyvä yleisavustaja, mutta omien tiedostojen hakuun tai koodaustehtäviin se ei ole paras valinta. Jos yhden latauksen odottaa hoitavan kaiken, yksi malli joutuu tekemään työt, joihin voisi valita kolme pientä mallia – kunkin omaan tehtäväänsä.
Paikallisen tekoälypaketin hallinta edellyttää selviä valintoja: minkä mallin ja sitä ajavan ohjelmiston valitset, millainen lisenssi mallilla on ja missä tietosi säilyvät. Jos et ole vielä tarkistanut kannettavasi keskus- tai näyttömuistia, lue ensin paljonko kannettava tarvitsee muistia paikalliseen tekoälyyn. Jos Ollama on vielä asentamatta, ensimmäisen paikallisen tekoälypalvelun käyttöönotto opastaa siinä. Tässä oletetaan, että molemmat on jo hoidettu. Seuraavaksi valitaan mallit: mikä sopii mihinkin, ja mistä tietää, onko malli hyvä?
Parhaat pienet tekoälymallit tehtävän mukaan
Hyödylliseen paikalliseen tekoälypakettiin kuuluu malli kolmeen eri tehtävään. Yhden mallin ei tarvitse yrittää hoitaa niitä kaikkia.
Yleisavustaja arkiseen keskusteluun, tekstien luonnosteluun ja nopeisiin kysymyksiin: qwen3.5:4b-q4_K_M. Latauksen koko on 3,4 Gt, ja tunniste on sama kuin sarjan toisessa osassa.
Pieni erikoismalli rajattuun tehtävään, kuten määrämuotoisen tulosteen tuottamiseen tai tarkasti määriteltyyn päättelytehtävään: granite4.2:3b. Latauksen koko on 2,2 Gt. Malli julkaistiin elokuussa 2026, ja sen lisenssi on Apache 2.0. Kuudennessa osiossa esitellään muita erikoismalleja koodaukseen, matematiikkaan, kuvien käsittelyyn ja kääntämiseen. Voit valita tämän tilalle omaan tehtävääsi sopivan mallin.
Upotusmalli omista asiakirjoista hakemiseen: embeddinggemma:300m. Latauksen koko on 622 Mt. Se ei vastaa keskustelukysymyksiin, vaan muuntaa tekstin vektoreiksi, joista hakusovellus etsii osumia. Kahdeksannessa osiossa kerrotaan, miten tämä toimii.
Kolmen latauksen yhteiskoko levyllä on noin 6,2 Gt. Se ei kerro niiden yhteenlaskettua muistintarvetta: kaikkien kolmen pitäminen yhtä aikaa muistissa voi silti ylittää kannettavan vapaan muistin määrän. Lataa muistiin yksi malli kutakin tehtävää varten, kokeile sitä oikealla työllä ja poista mallit, joista ei ole hyötyä.
Mitä kvantisointi muuttaa?
Kvantisoinnin vaikutuksen näkee helpoimmin vertaamalla saman malliperheen versioita. Ollaman luettelossa qwen3.5:9b-q4_K_M on 6,6 Gt, qwen3.5:9b-q8_0 11 Gt ja qwen3.5:9b-bf16 19 Gt. Mallin painot ovat samat, mutta tarkkuus ja latauskoko vaihtelevat.
Kyse on luettelon latauskoista, ei siitä, paljonko mallit varmasti vievät muistia käytössä. Pienempi tarkkuus vähentää tallennustilan tarvetta ja usein myös muistinkulutusta. Vastausten mahdollinen laadun heikkeneminen riippuu kuitenkin mallista, kvantisointitavasta ja tehtävästä. Älä oleta, ettei laatuhävikkiä ole tai ettei sillä ole väliä.
Mallipainot eivät myöskään ole ainoa muistin tarvitsija. Tilaa vievät lisäksi konteksti-ikkuna avain–arvo-välimuisteineen ja muut käynnissä olevat ohjelmat. Kvantisoinnilla vapautunut muisti ei siis yksin takaa, että suurempi malli mahtuu käyttöön. Se tekee kokeilusta realistisemman kuin aloittaminen täyden tarkkuuden tiedostolla.
Kaksi nimiloukkua, joista seuraa väärä lataus
Kaksi luettelomerkintää on helppo tulkita väärin. Kummassakin tapauksessa seurauksena on väärän mallin lataaminen.
Ensimmäinen ansa. Googlen oman mallikortin mukaan Gemma 4 E2B -mallissa on 2,3 miljardia ”tehollista” kieliparametria. Luku voi antaa vaikutelman pienestä tiedostosta, mutta Ollamassa latauksen koko on 7,2 Gt – lähes yhtä paljon kuin gemma4:12b-mallin Q4-version 7,6 Gt. Kun arvioit, mitä kannettavallesi mahtuu, katso latauskokoa äläkä parametrilukua.
Toinen ansa. Pelkkä malliperheen nimi voi ohjata lataamaan väärän version huomaamatta. Tunnisteella granite4.2 saat 5,3 Gt:n 8B-mallin, et toisessa osiossa mainittua 2,2 Gt:n 3B-versiota. Tunniste qwen3-embedding puolestaan lataa 4,7 Gt:n 8B-mallin, ei kahdeksannessa osiossa käytettävää 639 Mt:n 0.6B-versiota.
Ratkaisu on kummassakin tapauksessa sama: käytä aina täsmällistä mallitunnistetta, älä pelkkää malliperheen nimeä. Tarkista myös latauksen koko ennen kuin oletat saaneesi version, jota aiot kokeilla.
Miten pitkä konteksti Ollamassa on oletuksena?
Luettelossa ilmoitettu enimmäispituus, esimerkiksi 128K tai 256K tokenia, kertoo, kuinka pitkän syötteen malli voi periaatteessa vastaanottaa. Se ei lupaa, että 16 Gt:n kannettavan muisti riittää siihen.
Ollaman oletusarvoinen konteksti on 4 096 tokenia. Rajaa voi nostaa, mutta sekä pidempi konteksti että useammat samanaikaiset pyynnöt lisäävät muistintarvetta. Sarjan toisessa osassa käytetty num_ctx: 4096 vastaa tätä varovaista oletusarvoa, eikä ole sattumalta valittu pyöreä luku.
Aloita uuden mallin kokeilu 4 000–8 000 tokenin kontekstilla ja pidä käynnissä vain yksi istunto kerrallaan. Seuraa samalla koneen muistinkäyttöä. Pidennä kontekstia vasta, kun olet nähnyt muistin riittävän vakaasti – älä vain siksi, että luettelossa mainitaan suurempi mahdollinen arvo.
Paras pieni erikoismalli löytyy tehtävän mukaan
Yhtä kaikkiin tehtäviin sopivaa erikoismallia ei ole. Valitse kokeiltavat pienet mallit sen mukaan, mitä aiot niillä tehdä.
Koodaus: qwen2.5-coder:3b (1,9 Gt) tai suurempi qwen2.5-coder:7b (4,7 Gt). Molempien lisenssi on Apache 2.0.
Rajatut matematiikan tai logiikan tehtävät: Microsoftin phi4-mini:3.8b (2,5 Gt).
Kuvia ja näyttökuvia koskevat kysymykset: gemma4:e2b (7,2 Gt) tai gemma4:12b Q4 (7,6 Gt). Molempien lisenssi on Apache 2.0, ja molempien ilmoitetaan tukevan teksti- ja kuvasyötettä.
Monikielinen kirjoittaminen tai kääntäminen: aya-expanse:8b (5,1 Gt), joka on kehitetty 23 kielelle.
Yksi lisenssirajoitus on syytä sanoa suoraan: Aya Expanse 8B:n CC-BY-NC-4.0-lisenssi lisäehtoineen sallii ei-kaupallisen käytön. Älä oleta sen olevan vapaasti käytettävissä samalla tavoin kuin yllä mainitut Apache-lisensoidut mallit. Toisessa osiossa mainittu granite4.2:3b on edelleen yleiskäyttöinen päättelymalli, jos mikään näistä vaihtoehdoista ei sovi tehtävääsi.
Kokeile mallia omalla tehtävälläsi ennen kuin valitset sen. Erikoismalli ansaitsee paikkansa samoin kuin yleisavustaja: auttamalla työssä, johon sitä tarvitset, ei sijoittumalla jonkun muun vertailulistan kärkeen.
Testaa ennen kuin luotat: viisi toistettavaa koetta
Viisi lyhyttä koetta kertoo mallista enemmän kuin luettelosivu. Tee samat kokeet jokaisella ehdokkaalla ja käytä omaa aineistoasi.
1. Aineistoon perustuva tiivistelmä. Anna mallille 250 sanan muistiinpano ja pyydä siitä kolme jatkotoimenpidettä. Pyydä näyttämään myös virke, johon kukin toimenpide perustuu. Merkitse väitteet, joille tekstistä ei löydy tukea.
2. Määrämuotoinen tietojen poiminta. Keksi viisi tapaamista nimineen ja päivämäärineen. Pyydä JSON-vastaus, jossa on täsmälleen määrittämäsi kentät, ja tarkista kaikki viisi tapaamista kirjoittamistasi tiedoista.
3. Koodin korjaus. Anna mallille pieni funktio, joka ei läpäise testiä, sekä kyseinen testi. Kirjaa, meneekö testi läpi mallin korjauksen jälkeen. Käytä jokaisen vertailtavan mallin kanssa samaa koodivarastoa ja samoja taustatietoja.
4. Kielipari. Pyydä kieltä sujuvasti osaavaa lukijaa tarkistamaan, säilyvätkö realistisen kappaleen nimet, numerot ja vivahteet käännöksessä. Älä arvioi monikielisyyttä pelkän englanninkielisen kehotteen perusteella.
5. Kuvakysymys, vain kuvia käsitteleville malleille. Näytä kaavio tai näyttökuva, josta vastauksen voi tarkistaa. Varmista, että lähetit mallille itse kuvan etkä vain sen tiedostonimeä.
Kirjaa jokaisesta kokeesta, vastaako tulos tiedossasi olevaa oikeaa vastausta, noudattiko malli ohjeita ja keksikö se tietoja. Merkitse muistiin myös aika ensimmäiseen näkyvään tulosteeseen, kokonaisaika, tokenimäärät sekä se, käytettiinkö suoritinta vai näytönohjainta. Arvioi hyödyllisyys ja nopeus erikseen: ennen vastaamista päättelevä malli voi käyttää tuntuvasti aikaa tokeneihin, joita et koskaan näe.
Asiakirjahaku työkalupakin lisänä: paikallinen RAG
Toisessa osiossa mainitulla upotusmallilla on yksi tehtävä: se muuntaa tekstin vektoreiksi, joista hakusovellus voi etsiä osumia. Yksin se ei vastaa kysymyksiin.
Vaiheet etenevät tässä järjestyksessä: tiedostosi pilkotaan katkelmiksi, upotusmalli muuntaa kunkin katkelman vektoriksi ja paikallinen vektoritietokanta tallentaa vektorit. Myös kysymyksesi muunnetaan vektoriksi. Haku palauttaa lähimmät katkelmat, ja vasta sen jälkeen keskustelumalli muodostaa niiden perusteella vastauksen ja viittaa niihin.
Keskustelumallia ei ole koulutettu asiakirjoillasi. Se näkee vain sen, mitä haku sille antaa kysymyshetkellä.
Ajatusta voi kokeilla ilman suurta valmistelua: indeksoi viisi muistiinpanoa, jotka sinulla jo on. Kirjoita yksi kysymys, johon vastaus löytyy yhdestä niistä, ja toinen, johon vastausta ei ole yhdessäkään viidestä. Toimiva järjestelmä hakee ensimmäiseen kysymykseen oikean kohdan ja viittaa siihen. Toiseen se myöntää, ettei vastausta tukevaa tietoa löydy, sen sijaan että keksisi vastauksen. Arvioi haun onnistuminen ja lopullinen vastaus erikseen.
Tarkista upotusmallin täsmällinen tunniste ennen latausta: embeddinggemma:300m tai qwen3-embedding:0.6b. Syy on sama kuin neljännessä osiossa käsiteltyjen pelkkien perhetunnisteiden kohdalla.
Miksi harvemmat aktiiviset parametrit eivät pienennä tallennustarvetta?
Esimerkiksi tunnisteella ”26B A4B” merkitty malli käyttää kunkin tuottamansa tokenin kohdalla vain osaa parametreistaan. Kaikkien 26 miljardin parametrin painojen on silti oltava jossakin tallessa tai niitä on siirrettävä käyttöön tarpeen mukaan. Aktiivisten parametrien pienempi määrä ei siis tarkoita pienempää tiedostoa eikä pienempää muistintarvetta.
Tässä työkalupakissa ei esitetä uusia, sitä varten mitattuja suorituskykytuloksia. Jos luku on peräisin muualta, tulkitse se sen mukaisesti. Esimerkiksi eräs käyttäjä ilmoitti saaneensa noin 18,5 tokenia sekunnissa poikkeuksellisella kokoonpanolla: 26B:n asiantuntijasekoitemalli, vanhempi suoritin ja 6 Gt:n näytönohjain. Kyse on yhden ihmisen tuloksesta hänen omalla laitteistollaan, ei yleisestä odotuksesta kaikille samalla merkinnällä varustetuille malleille.
Kannettavat, joilla työkalupakkia testattiin
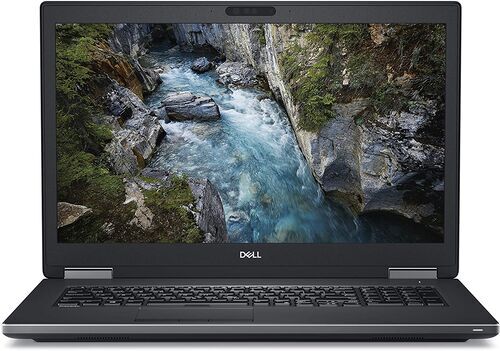
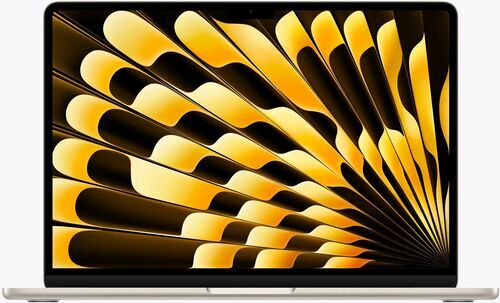
Tätä työkalupakkia testattiin kahdella käytössä olevalla kannettavalla, samoilla kuin sarjan toisessa osassa. Toinen on Applen järjestelmäpiirillä varustettu perustason kone, toinen Windows-työasema, jossa on erillistä näyttömuistia. Ammattilaiset ovat testanneet, puhdistaneet ja kunnostaneet molemmat. refurbedissa kummallakin on 12 kuukauden takuu, ja molemmilla tämä työkalupakki toimii vaivatta, yksi malli kerrallaan.
13-tuumaisessa MacBook Airissa (2026), jossa on M5-siru, on vakiona 16 Gt yhtenäistä muistia. Sen saa myös jopa 32 Gt:n muistilla. Dell Precision 7730:ssa on 32 Gt keskusmuistia ja erilliset 6 Gt NVIDIA-näyttömuistia. Kyse on kahdesta eri muistialueesta, ei yhdestä yhteenlasketusta muistimäärästä.
Tässä kannettavat eivät ole myyntipuhe, vaan kokeilun vertailukohtia. Niiden avulla voit verrata omaa konettasi johonkin konkreettiseen markkinointiesitteen teknisten tietojen sijaan.
Tarkista lisenssi ja pidä mallivalikoima kurissa
Lisenssi koskee täsmällistä mallia, ei koko malliperhettä. Qwen3.5 4B-, Qwen2.5-Coder-, Granite 4.2 3B- ja Gemma 4 E2B -mallien lisenssi on Apache 2.0. Aya Expanse 8B käyttää CC-BY-NC-4.0-lisenssiä lisäehtoineen ja on tarkoitettu ei-kaupalliseen käyttöön, kuten kuudennessa osiossa todettiin. Mahdollisuus ladata mallin painot, tekijänoikeuden haltijan lupa käyttää niitä ja taustalla olevan mallin ”omistaminen” ovat kolme eri asiaa. Tarkista siksi lataamasi täsmällisen mallin ajantasainen mallikortti, älä pelkkää malliperheen nimeä.
Mallivalikoiman pitäminen pienenä vaatii säännöllistä karsimista. Komento ollama rm poistaa latauksen, jolle ei löytynyt käyttöä. Voit esimerkiksi kirjoittaa ollama rm aya-expanse:8b, kun tiedät, ettet käytä kyseistä mallia. Komento ollama ls näyttää, mitä levylle on tallennettu, ja ollama ps näyttää, mitä muistiin on ladattu. Luettelot muuttuvat, joten tarkista mallivalintasi välillä uudelleen äläkä luota kuukausia vanhaan päätökseen.
Pienikin malli voi keksiä katkelman, hukata toisen kielen vivahteen tai kirjoittaa koodia, joka näyttää oikealta mutta ei läpäise testiä. Kokeile jokaista tämän oppaan suositusta itse. Tärkeissä asioissa kokeilu ei korvaa asiantuntijan arviota.
Usein kysytyt kysymykset pienistä paikallisista tekoälymalleista
Voinko käyttää kaikkia kolmea työkalupakin mallia yhtä aikaa? 16 Gt:n kannettavalla se ei luultavasti onnistu vaivatta. Lataa muistiin kulloinkin tarvitsemasi malli ja vaihda sitä tehtävän mukaan sen sijaan, että pitäisit yleisavustajan, erikoismallin ja upotusmallin yhtä aikaa muistissa.
Tarvitsenko upotusmallia varten näytönohjaimen? Et. embeddinggemma:300m on riittävän pieni kokeiltavaksi pelkällä suorittimella. Mittaa kuitenkin, kuinka nopeasti se toimii, äläkä oleta sen vastaavan heti.
Antaako suurempi malli aina paremman vastauksen? Ei. Tehtävä ratkaisee, pärjääkö 4B- vai 9B-malli paremmin. Siksi seitsemännessä osiossa esitellään viiden kokeen menetelmä sen sijaan, että valinta perustuisi yhteen vertailulistan pistelukuun.
Riittääkö Q4-version laatu? Se riippuu tehtävästä. Jos muistia riittää kummankin version ajamiseen, vertaa Q4-tunnistetta saman mallin Q8-versioon kolmella omalla kokeellasi, kuten kolmannessa osiossa.
Voinko käyttää Aya Expansea kaupallisessa projektissa? Et lähtökohtaisesti. Sen CC-BY-NC-4.0-lisenssi lisäehtoineen kattaa ei-kaupallisen käytön. Tarkista ajantasainen mallikortti ennen kuin oletat muuta.
Tarvitseeko upotusmalli lataamisen jälkeen verkkoyhteyden? Ei. Muiden tämän työkalupakin mallien tavoin se toimii ilman verkkoyhteyttä, kun mallin painot ovat levyllä.
Nyt on sinun vuorosi: asenna, testaa ja pidä hyödylliset mallit
Asenna 4B-yleisavustaja ja omaan tehtävääsi sopiva erikoismalli kannettavallesi. Sarjan ensimmäinen osa auttoi arvioimaan sen muistintarvetta ja toinen ottamaan paikallisen tekoälyn käyttöön. Tee seitsemännen osion kokeista oma kolmen kysymyksen versiosi. Pidä malli, josta on apua, ja poista toinen komennolla ollama rm. Harkitse lisämuistin ostamista vasta, kun todellinen tehtävä osoittaa muistin olevan rajoittava tekijä. Pelkkä teknisten tietojen luettelo ei sitä kerro.
Tähän päättyy kolmiosainen sarja. Jos oma kannettavasi tarvitsee ensin lisää kapasiteettia, kannettavien tietokoneiden kategoriasta on hyvä aloittaa.

Liity ensimmäistä kertaa uutiskirjeen tilaajaksi ja säästä 15 €!
Älä missaa enää yhtäkään tarjousta.
Lisätietoja henkilötietojen käytöstä löydät tietosuojaselosteestamme.
Hanki refurbed-sovellus
iOS:lle ja Androidille
Vahvista rekisteröityminen
Napsauta linkkiä lähettämässämme vahvistussähköpostissa saadaksesi etukuponkisi. Sen voi käyttää vähintään 200 euron ostokseen.
- © Refurbed Marketplace GmbH
- Saavutettavuudet
- Ehdot
- Tietosuojaseloste
- Julkaisutiedot
- Oikeudelliset ilmoitukset
- European Data Act
- Cookie Policy